01В чём фокус
GPT-6 Astra в Codex сильнее моделей, с которыми ты работал раньше, а привычки у тебя остались от них. Ставишь максимальное усилие, чтобы наверняка. Держишь AGENTS.md, в котором за год накопились правила капсом. Ведёшь один чат всю неделю, руками копируешь ошибки из браузера, печатаешь длинные задания и принимаешь работу по слову «готово».
Со старыми моделями это кое-как работало, потому что многое они додумывали сами, а Astra устроена иначе. В гайде OpenAI по этой модели сказано, что длинные задачи она держит лучше GPT-5.6 Sol, но чаще переспрашивает там, где прошлые модели молча предполагали. И что к инструкциям в навыках и AGENTS.md она чувствительнее. Отсюда два следствия. Старые подпорки она выполняет старательнее, чем они того заслуживают, а на размытую задачу отвечает вопросом вместо работы.
Дальше разобраны семь таких привычек. Для каждой сказано, почему она мешает именно сейчас, что поставить вместо неё и как это выглядит на наших задачах: Telegram-бот, лендинг с формой заявки, которая падает в Telegram, воркфлоу в n8n, небольшой сервис, собранный в Codex. Промпты в тексте можно копировать как есть и править под свой проект.
В конце четыре шага на сорок минут. После них Codex настроен под Astra, а одна боевая задача покажет, что изменилось.
02Что нужно до старта
Нужен Codex в любом виде. Он живёт в десктопном приложении ChatGPT рядом с Chat и Work, а ещё есть командная строка и расширение для редактора. Почти всё ниже работает везде. Встроенный браузер есть только в приложении, в командной строке и редакторе его нет, это отдельно отмечено в шестом разделе.
У Codex есть тарифы Free, Go за $8, Plus за $20 и Pro от $100 (ступени $100, $200 и $500). Какие модели и уровни усилия доступны лично тебе, видно в выборе модели в приложении. Если Astra там нет, большая часть гайда всё равно пригодится: привычки про контекст и приёмку от модели не зависят.
Для пробы возьми проект, который не жалко: бот, лендинг или сервис, где уже лежит AGENTS.md. Если файла ещё нет, ещё лучше: начнёшь сразу с короткого.
По времени это сорок минут на настройку и одна обычная рабочая задача, чтобы увидеть разницу.
Настройка сама по себе ничего не стоит. Лимит уходит на задачи, и на его расход первая привычка из списка влияет сильнее остальных. Голос оплачивается отдельной строкой из того же бюджета Codex, цена в разделе про него.
03Ядро
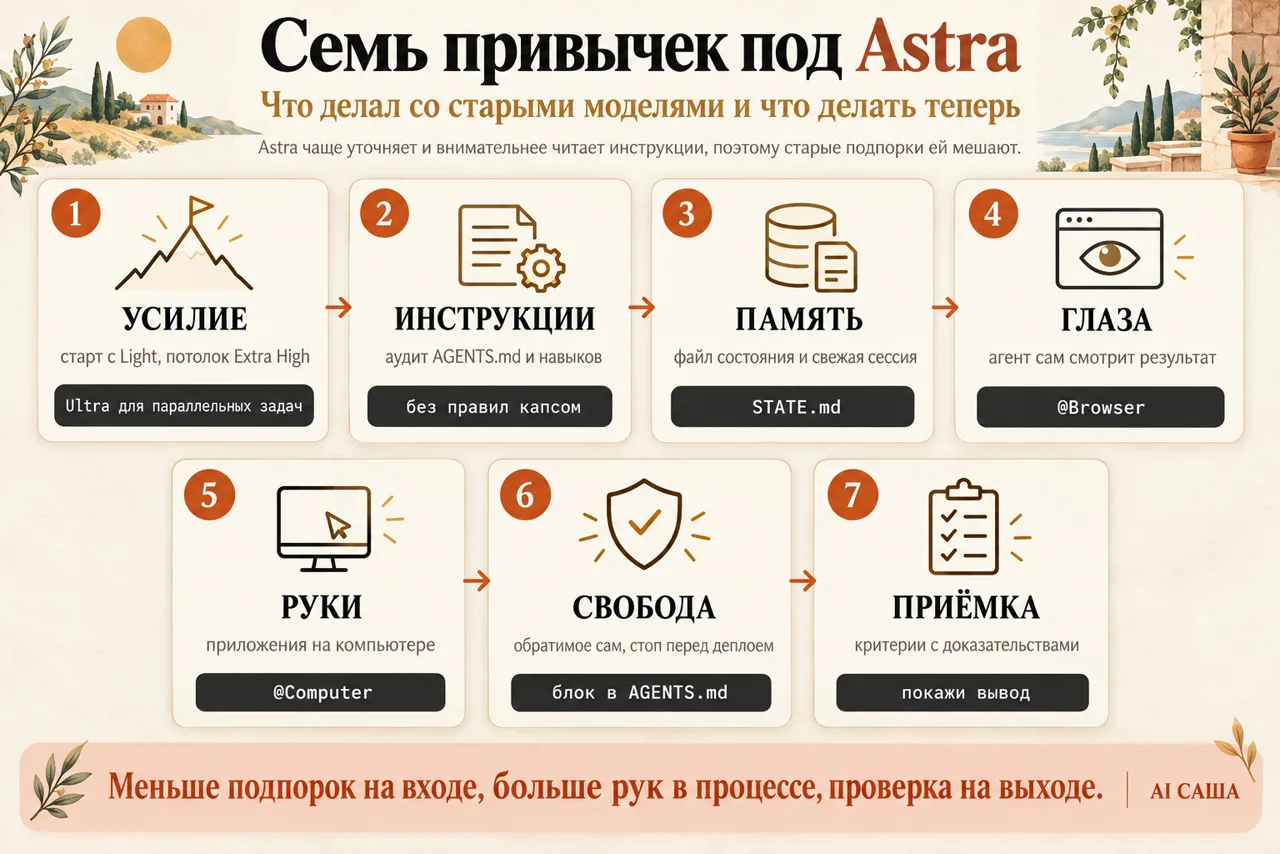
Семь привычек и семь замен. Читать их удобно парами: что делал раньше и что делать с Astra.
- Максимум на всякий случай. Вместо этого начинать с Light и поднимать уровень по результату, потолок Extra High, а Ultra держать для задач, которые делятся на параллельные части.
- Инструкции копятся годами. Вместо этого раз в несколько месяцев проводить аудит AGENTS.md и навыков и выкидывать подпорки, написанные под старые модели.
- Один бесконечный чат. Вместо этого файл состояния в проекте и свежая сессия, а
/compactтолько внутри одной задачи. - Глаза и руки за агента. Вместо этого встроенный браузер
@Browserдля страниц и Computer Use@Computerдля приложений на компьютере. - Печатать всё руками и сидеть рядом. Вместо этого голос: наговорил задачу, голосовой агент сам запускает работу и докладывает.
- Расписывать каждый шаг или ждать, что догадается. Вместо этого один блок в AGENTS.md, который задаёт меру свободы: что делать самому, где остановиться.
- Верить слову «готово». Вместо этого критерии приёмки, которые агент проверяет сам и по каждому показывает доказательство.
Привычки складываются в три группы. Первые три про то, что агент читает: уровень усилия, инструкции и историю разговора. Четвёртая и пятая про его руки и твоё участие. Последние две про постановку задачи и приёмку.
Если упростить до одного правила: меньше подпорок на входе, больше рук в процессе и проверяемая граница на выходе. Astra хорошо работает, когда ей не мешают старые костыли, когда она может сама посмотреть на результат и когда ясно, где заканчивается её самостоятельность. Каждый из следующих четырёх разделов закрывает свою часть этого правила.
04Усилие и инструкции
Про уровни усилия и лимиты есть отдельный гайд по Codex, ссылка в конце. Здесь только то, что нужно для привычки.
Привычка 1. Максимум, чтобы наверняка
В Codex шесть уровней усилия: Light, Medium, High, Extra High, Max и Ultra. В командной строке Light называется Low. Max и Ultra появляются на ползунке в зависимости от настроек. В приложении есть пресет Power с ползунком от Faster к Smarter, а в разделе Advanced модель, усилие и скорость выставляются по отдельности.
Старая логика звучала так: поставлю повыше, хуже не будет. С Astra хуже бывает, только не по качеству, а по цене. В посте OpenAI про GPT-6 Astra есть график независимого индекса Artificial Analysis для агентов-программистов. Балл Astra и цена одной задачи на разных уровнях:
- Low: 62,6 балла, $1,50 за задачу;
- Medium: 65,3 балла, $2,33;
- High: 65,5 балла, $3,07;
- Xhigh: 67,0 балла, $3,46;
- Max: 67,0 балла, $4,98.
Max набирает ровно столько же, сколько Xhigh, и стоит на 44% дороже. На длинных задачах бенчмарка DeepSWE картина та же: max не лучше xhigh и обходится в 1,7 раза дороже.
Что из этого следует на практике.
Начинать стоит с Light. Так советует и OpenAI: Light для Astra, High для Luna. Это рекомендация, а не значение по умолчанию: что стоит у тебя, посмотри в выборе модели. Правка текста на лендинге, новый обработчик команды в боте, переименование узлов в n8n на Light проходят нормально.
Если ответ не дотянул, поднимай уровень на одну ступень и повторяй. Прыгать сразу на Max незачем, по цифрам выше это переплата без прироста.
Для трудной задачи потолок Extra High: это верхний уровень для одной ветки рассуждений.
Ultra нужен для другой работы. Он не про «подумать глубже»: он разбивает задачу на части и раздаёт их параллельным субагентам. Это имеет смысл, когда работа и правда делится: например, в сервисе нужно одновременно переписать обработчики, обновить тесты и поправить документацию. На одной хитрой ошибке Ultra ничего не добавит, там нужна одна сильная ветка рассуждений.
Привычка 2. Инструкции, которые копились годами
Codex читает AGENTS.md до любой работы. Сначала глобальный файл ~/.codex/AGENTS.md, потом файлы от корня проекта вниз по папкам, и ближний к задаче важнее дальнего. Предел размера 32 КиБ. В гайде OpenAI по Astra отдельно сказано, что эта модель чувствительнее к инструкциям в навыках и AGENTS.md, и прямо советуют их пересмотреть.
Посмотри на свой файл глазами новой модели. Там почти наверняка есть следы старых битв: «ВСЕГДА пиши файл целиком», «НИКОГДА не задавай вопросов», «думай шаг за шагом», обход ошибки, которую давно исправили, три правила про одно и то же в разных формулировках. Раз Astra к инструкциям чувствительнее, выполнять такие правила она будет старательно, даже там, где правило уже вредит: например, перепишет весь файл ради одной строки или промолчит, когда вопрос был бы к месту.
Аудит удобнее отдать самому агенту, но с запретом на правку:
Прочитай все AGENTS.md, которые видишь в этом проекте, включая глобальный.
Ничего не меняй. Собери таблицу: правило, в каком файле лежит, зачем оно,
судя по всему, было нужно, что изменится, если его убрать.
Отдельно отметь:
- правила капсом и со словами «всегда» и «никогда»;
- обходы ошибок, которые могли исправить в новых моделях;
- правила, которые противоречат друг другу или повторяют друг друга;
- то, что агент и так узнает из кода: структуру папок, команды из package.json.
В конце предложи короткую версию каждого файла и покажи дифф.
Записывать будешь, когда я скажу «применяй».
Хороший AGENTS.md после чистки обычно отвечает на несколько вопросов: как запустить проект и тесты, где лежат секреты и куда их нельзя класть, что нельзя трогать без спроса, как называть ветки и коммиты. Остальное агент увидит в коде сам.
С навыками та же история, только проверять их труднее: навык может годами срабатывать не вовремя, и ты этого не замечаешь. Для этого у Anthropic есть skill-creator. Он помогает создать и улучшить навык, прогнать проверки с навыком и без него, замерить разницу и подобрать описание так, чтобы навык включался тогда, когда нужен. Сделан он под Claude, но сам способ переносится на любой агент: одна задача с навыком, та же задача без него, сравнение.
В Claude Code эта привычка выглядит так же, только файл называется CLAUDE.md. Борис Черни, который делает Claude Code, рассказывал летом на YC Startup School, что к выходу Opus 5 команда выкинула большую часть системного промпта, и советовал раз в полгода удалять CLAUDE.md и собирать его заново. Для Codex вывод тот же, что в гайде OpenAI: файл, собранный под прошлую модель, стоит пересмотреть под новую.
05Память между сессиями
Привычка 3. Один бесконечный чат
Удобно держать всё в одном разговоре: там вся история, решения, ошибки. Со временем начало разговора сжимается, ранние договорённости теряют детали, и агент принимается спорить с решением, которое вы вместе приняли во вторник. Длинная история к тому же дорожает: каждый новый ход тянет её за собой.
Замена такая: состояние живёт в файле проекта, а разговор становится одноразовым.
Заведи файл состояния в корне проекта и назови как удобно, например STATE.md. Агент обновляет его в конце каждого шага, новая сессия начинается с его чтения. Пример для воркфлоу n8n, который собирает заявки с лендинга:
# Состояние: заявки с лендинга в Telegram

## Цель
Заявка с формы попадает в n8n, проверяется и уходит в чат менеджеров.

## Сделано и проверено
- Webhook-узел принимает POST с полями name и phone, тестовый запрос прошёл.
- Узел проверки отбрасывает телефон короче 10 цифр.

## В работе
- Узел Telegram: credentials заведены под именем tg-leads, сообщение не уходит,
  ошибка 400 в логе выполнения.

## Решения
- Дубли ловим по телефону за последние сутки, не по имени.

## Дальше
1. Починить отправку в Telegram.
2. Добавить ветку ошибок: упавшая заявка пишется в таблицу.
Значения ключей в файл не пишутся, только имена, под которыми они заведены.
Чтобы не напоминать агенту каждый раз, добавь в AGENTS.md одну строку:
В конце каждого шага обнови STATE.md: что сделано и чем проверено, что в работе,
какие решения приняты, что дальше. Новую сессию начинай с чтения STATE.md.
Остаётся решить, когда хватит /compact, а когда нужна новая сессия. Команда /compact есть и в командной строке, и в приложении: она сжимает историю текущего разговора. Ею удобно пользоваться внутри одной задачи, когда ты на середине и терять ход мысли не хочется. Задача сменилась или агент начал противоречить сам себе, тогда открывай новую сессию и начинай с файла состояния.
У Astra в Codex есть ещё экспериментальный режим заметок между окнами контекста. Его можно попробовать, но свой файл держи всё равно: он лежит в проекте, читается глазами и переживает смену модели, инструмента и даже переход из Codex в Claude Code.
В Claude Code приём тот же: /compact на месте, а файл передачи дел в корне проекта делает ту же работу, что STATE.md.
06Руки и голос
Привычка 4. Глаза и руки за агента
Старый цикл выглядел так: агент поправил лендинг, ты открыл браузер, увидел, что кнопка уехала, сделал скриншот, вставил в чат, описал словами. Заметная часть времени уходила на то, чтобы быть глазами агента.
Для страниц в десктопном приложении ChatGPT у Codex есть свой браузер. Вызывается он упоминанием @Browser или обычной просьбой открыть страницу. У него отдельный профиль, твои вкладки он не трогает, и перед заходом на сайт он спрашивает разрешения. Файлы через него не загружаются. В командной строке и в редакторе браузера нет.
Задача для лендинга с формой заявки:
@Browser открой локальную версию лендинга. Заполни форму тестовыми данными:
имя «Тест», телефон +7 900 000-00-00. Отправь. Проверь, что появилось сообщение
об успехе и что в консоли нет ошибок. Потом сузь окно до ширины телефона
и проверь, что форма и кнопка видны без горизонтальной прокрутки.
Если что-то не так, почини и повтори проверку сам.
Последняя строка здесь главная. Агент сам видит результат и сам замыкает цикл «поправил, проверил, поправил».
Когда нужно не веб, а программа на компьютере, есть Computer Use. Это плагин: вкладка Plugins, пункт Computer Use. Вызывается упоминанием @Computer или по имени приложения, например @Chrome. Работает на macOS и Windows. На macOS ему нужны права на запись экрана и универсальный доступ. На Windows он забирает экран целиком и в фоне не работает: пока он кликает, ты за компьютером не работаешь.
Выбирать между ними стоит так: сначала браузер, если задача в вебе, а Computer Use, когда без настоящего приложения никак: проверить, как десктопный клиент показывает сообщение от бота, или пройти сценарий в программе без веб-версии. На Windows такие проверки удобно собирать в одну и запускать, когда отходишь от компьютера.
Привычка 5. Печатать всё руками и сидеть рядом
Длинное задание руками печатается неохотно, и в него попадает меньше контекста, чем у тебя в голове. А потом ты сидишь и смотришь, как агент работает, потому что иначе не узнаешь, когда он закончит.
В Codex появился голосовой режим. В существующих задачах он раскатывается постепенно, так что у тебя его может пока не быть. Устроен он так: ты разговариваешь с голосовым агентом, а он запускает отдельные задачи, проверяет их и докладывает тебе. На DevDay 29 сентября OpenAI объявила голос в Codex CLI и экран /agents.
Для нашей ниши сценарий выглядит так. Голосом рассказываешь всё, что знаешь о проблеме: бот отвечает на /start, но молчит на /price, вчера меняли таблицу с ценами, в логах что-то про пустую строку. Попутно просишь поменять текст кнопки на лендинге. Голосовой агент заводит две задачи, следит за ними и потом коротко рассказывает, что сделано и где нужна твоя проверка.
По цене лимиты у голоса общие с тарифом. Минута голоса стоит $0,05 из бюджета Codex (это 1,25 кредита), а модель, которая делает саму задачу, оплачивается отдельно, как обычно. Голосовой чат одновременно может быть только один.
Голос не заменяет критерии приёмки из седьмого раздела. Он убирает две вещи: необходимость печатать и необходимость сидеть рядом.
07Сколько свободы дать и как принять работу
Привычка 6. Расписывать каждый шаг или ждать, что догадается
С прошлыми моделями было два лагеря. Одни расписывали задачу по шагам, потому что иначе модель уходила не туда. Другие писали одну строку и рассчитывали, что модель додумает. С Astra оба подхода дают сбой. По гайду OpenAI, длинные задачи она держит лучше GPT-5.6 Sol, но там, где старая модель предположила бы и пошла дальше, Astra чаще уточняет.
Для этого в гайде OpenAI по Astra, в разделе про инициативу и доведение до конца, есть три вставки в промпт. Своими словами они говорят вот что.
Первая вставка про намерение: выводи, чего хочет человек, из контекста, действуй и доводи до цели. Обратимое делай сам: ветки, разбор конфликтов, чтение файлов, черновой PR. Останавливайся только перед разрушительным и необратимым.
Вторая про формулировки: «можешь…», «хочу…», «помоги…» означают «сделай». Это не повод ответить «да, могу», прислать план вместо работы или сдать половину.
Третья про одобрение: сначала доделай всё, что разрешено, и только потом проси одобрения, причём на готовый проверяемый результат. Одобрение нужно перед деплоем, записью во внешнее приложение, слиянием PR, публикацией сайта. На чтение и обратимые шаги разрешение не нужно.
Из этого собирается один блок в AGENTS.md. Наша версия на русском:
## Как работать
- Пойми из контекста, чего я хочу, и доводи до результата. Обратимое делай сам:
  ветки, чтение файлов, разбор конфликтов, черновой PR. Останавливайся только
  перед тем, что удаляет данные или что нельзя откатить.
- «Можешь», «хочу», «помоги» значат «сделай». Не отвечай «да, могу»,
  не присылай план вместо работы и не сдавай половину.
- Сначала доделай всё разрешённое, потом проси одобрения на готовый результат,
  который я могу проверить. Одобрение нужно на деплой, запись во внешний сервис,
  слияние PR и публикацию сайта. На чтение и обратимые шаги не спрашивай.
Как это выглядит на боте. Пишешь: «хочу, чтобы бот на /price отвечал ценами из таблицы». Без блока легко получить в ответ план из пяти пунктов и вопрос, начинать ли. С блоком агент заводит ветку, пишет обработчик, гоняет его локально на тестовых данных и останавливается перед деплоем: вот изменения, вот проверка, деплоить?
Одна оговорка из того же гайда OpenAI: даже с такими вставками модель по умолчанию задаёт неблокирующие вопросы по ходу работы. Это нормальное поведение, работа при этом не стоит. Отвечай, когда удобно. Если вопрос всё-таки блокирует работу, значит, в задаче не хватило контекста, и это повод дописать AGENTS.md.
В Claude Code тот же блок без изменений ложится в CLAUDE.md.
Привычка 7. Верить слову «готово»
Агент пишет «готово», ты деплоишь, а форма на телефоне не отправляется. Модели стали сильнее, но «готово» по-прежнему значит «я закончил то, что считал задачей». Чтобы это совпадало с твоей задачей, её конец надо описать проверками.
Критерий приёмки пишется так, чтобы агент мог проверить его сам и показать доказательство. «Красиво» и «удобно» не критерии. «Нет горизонтальной прокрутки на ширине 375 px, вот снимок» уже критерий.
Пример для лендинга с формой заявки в Telegram:
Готово значит: выполнены все пункты ниже, и по каждому ты показал доказательство.
1. Форма отправляет имя и телефон, сервер отвечает 200. Покажи ответ.
2. Заявка приходит в тестовый чат Telegram. Покажи текст сообщения из лога.
3. Пустое имя и телефон из букв форма не отправляет, под полем видна ошибка.
4. На ширине 375 px нет горизонтальной прокрутки: открой страницу через @Browser
   и сделай снимок.
5. Токен бота не попал в репозиторий: покажи вывод git check-ignore .env.
Если какой-то пункт не прошёл, так и напиши: какой и почему.
Слов «почти готово» в отчёте быть не должно.
Три правила, которые делают критерии рабочими.
Первое: критерии ставятся в начале задачи, тогда агент планирует работу под них, а не подгоняет отчёт задним числом.
Второе: пункт без доказательства не засчитывается. Ответ сервера, строка лога, снимок экрана, вывод команды. Если агент пишет «проверил» без вывода, просишь вывод.
Третье: критерии стыкуются с одобрением. Третья вставка из прошлой привычки просит одобрение на проверяемый результат. Критерии и делают его проверяемым: ты смотришь на пять доказательств, а не на слово «готово».
Если в форме есть загрузка файла, этот пункт проверяй сам: встроенный браузер файлы не загружает.
08Свой результат за 40 минут
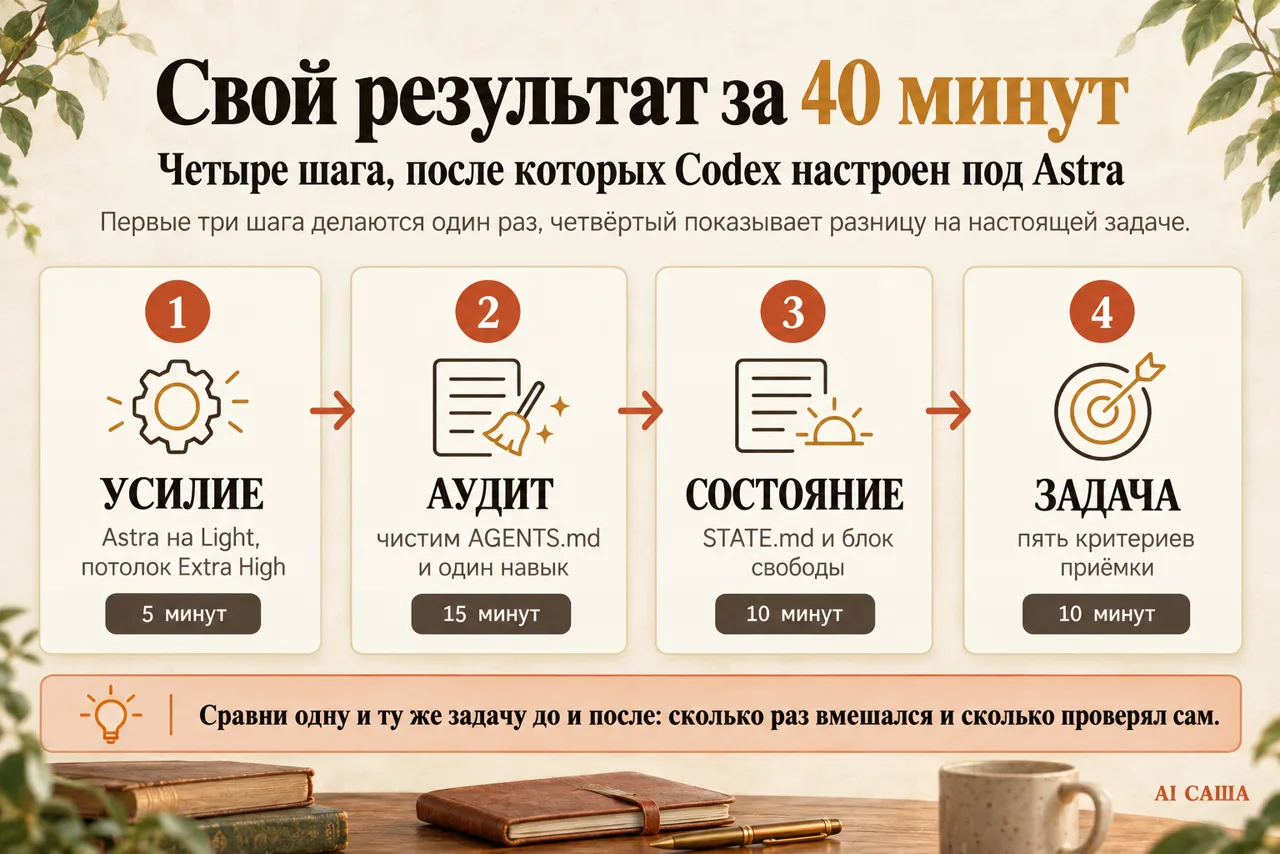
Здесь четыре шага: первые три настраивают Codex один раз, четвёртый показывает разницу на настоящей задаче.
Шаг 1. Усилие, 5 минут
Открой выбор модели и поставь Astra на Light. Если Max и Ultra включены на ползунке, запомни правило: Extra High это потолок для одной ветки рассуждений, Ultra только для работы, которая делится на параллельные части. В командной строке тот же уровень называется Low.
Шаг 2. Аудит инструкций, 15 минут
Запусти промпт аудита из четвёртого раздела. Пройди таблицу глазами, вычеркни правила капсом, обходы старых ошибок и всё, что агент видит в коде сам. Скажи «применяй» только после того, как посмотрел дифф. Если навыков много, выбери один, который включается чаще всех, и проверь его на одной задаче с навыком и без.
Шаг 3. Файл состояния и блок свободы, 10 минут
Создай STATE.md по шаблону из пятого раздела, добавь в AGENTS.md строку про его обновление и блок «Как работать» из седьмого. Теперь каждая новая сессия начинается с контекста, а агент знает, где его самостоятельность заканчивается.
Шаг 4. Одна задача с критериями приёмки, 10 минут на постановку
Возьми задачу, которую и так собирался сделать: новая команда бота, поле в форме лендинга, ветка ошибок в воркфлоу. Напиши её одной-двумя фразами, добавь пять критериев с доказательствами и, если проект веб, проверку через @Browser. Запускай на Light, а если результат не дотянул, подними уровень на одну ступень и повтори.
После задачи открой STATE.md и посмотри, что агент туда записал. Если в файле можно разобраться без чата, настройка работает.
09Что ты увидишь
До настройки на любой задаче стоит Max, потому что так спокойнее. AGENTS.md на несколько экранов, правила капсом. Чат тянется третий день, и агент забывает, о чём договорились в начале. На просьбу «можешь добавить поле в форму» приходит «да, могу, вот план». После «готово» ты сам открываешь браузер, находишь, что на телефоне кнопка уехала, делаешь скриншот и пишешь в чат.
После настройки задача стартует на Light и поднимается, только когда ответа не хватило. AGENTS.md короткий, в нём то, чего не видно из кода. Каждая сессия начинается с STATE.md, а длинный чат больше не нужен. Агент сам заводит ветку, делает работу, проверяет страницу через @Browser и останавливается перед деплоем с пятью доказательствами в отчёте. Вопросы по ходу он задаёт, но работу из-за них не бросает.
Сравнивать лучше на одной и той же задаче. Возьми типовую правку, которую делал недавно, и повтори её после настройки: сколько раз пришлось вмешаться, сколько раз проверял сам, на каком уровне усилия закончил. Разница в этих трёх вопросах и есть результат гайда.
10Чтобы не споткнуться
Дать свободу и не назвать необратимое. Блок «Как работать» без списка того, что требует одобрения, превращается в разрешение на всё. Деплой, запись во внешний сервис, слияние PR и публикация сайта должны быть названы явно. Если у тебя есть своё необратимое, например рассылка по базе клиентов бота или удаление записей в таблице, допиши его в тот же список.
Критерии, которые агент не может проверить. «Сделай удобно» и «пусть выглядит аккуратно» агент закроет словом «готово», и спорить будет не с чем. Каждый пункт должен заканчиваться действием, которое можно выполнить и показать: ответ сервера, снимок, вывод команды, сообщение в чате.
Computer Use посреди своей работы на Windows. Он забирает экран и в фоне не работает. Запустишь его, пока сам пишешь сообщение в соседнем окне, и мешать будете друг другу. Собирай такие проверки в одну задачу и запускай, когда отходишь.
11А если…
…Astra всё равно спрашивает по мелочам? Неблокирующие вопросы по ходу работы для неё обычны даже с блоком «Как работать», это сказано в гайде OpenAI. Проверь, не стоит ли работа. Если не стоит, отвечай, когда удобно. Если стоит, в задаче не хватило контекста: допиши его в AGENTS.md или в саму задачу.
…я работаю в командной строке, а @Browser там нет? Браузер есть только в десктопном приложении. В командной строке проверяй страницу тестами: попроси агента написать сквозной тест на форму и включить его прогон в критерии приёмки. Для ручных проверок держи приложение открытым рядом.
…Light не справился? Подними уровень на одну ступень и повтори. Если не справился и Extra High, вопрос, скорее всего, не в усилии, а в постановке: перечитай критерии и проверь, хватает ли агенту контекста.
…голоса у меня нет? Он раскатывается постепенно и в существующих задачах появляется не у всех сразу. Всё остальное из гайда обходится без него.
…это работает в Claude Code? Логика та же. AGENTS.md там называется CLAUDE.md, навыки есть, /compact есть, файл состояния и блок «Как работать» переносятся без изменений. Критерии приёмки от инструмента не зависят вообще.
12Зачем на самом деле
Все семь замен про одно: как работать с исполнителем, который стал сильнее тебя в своей части работы. Ему не нужны костыли, зато ему нужны ясная цель, право действовать в обратимом, граница перед необратимым и понятное определение «готово».
Это те же вещи, которые нужны живому подрядчику. Человек, который умеет так ставить задачу агенту, умеет ставить её и команде: коротко, с контекстом в файле, с критериями приёмки. На вайбкодинге это видно особенно хорошо, потому что между твоей мыслью и работающим сервисом стоит только постановка задачи.
И это переживёт Astra. Выйдет следующая модель, сменятся названия уровней и цены, появятся новые кнопки. Привычка чистить инструкции под новую модель, держать состояние в файле, давать агенту глаза и проверять результат доказательствами останется рабочей.
13А дальше
GPT-6 Astra выедает лимит быстрее всех про лимиты Codex целиком: на что они уходят, быстрый режим, контекст каждого хода, субагенты на дешёвых моделях. Первая привычка отсюда там разобрана подробно.
Агент чинит одно и тихо ломает другое про тесты. Критерии приёмки из седьмой привычки хорошо превращаются в автотесты, и тогда проверка повторяется сама на каждой правке.
Один Клод не справляется. Собери рой про субагентов: пригодится, когда задача правда делится на части, и Ultra или своя команда агентов окупаются.
Если хочешь собирать такие вещи вместе с людьми, которые делают то же самое в Codex, Claude Code, n8n и Make, заходи в клуб NeyroMakers: neyrohub.ru/neyromakers.
14Источники
- Гайд OpenAI по GPT-6 Astra: чувствительность к инструкциям, раздел про инициативу и три вставки в промпт.
- GPT-6 Astra, пост OpenAI: график индекса Artificial Analysis с баллом и ценой задачи на каждом уровне усилия.
- Модели и уровни усилия в Codex: уровни от Light до Ultra, рекомендации по старту, пресет Power.
- AGENTS.md в Codex: порядок чтения файлов, приоритет ближнего, предел 32 КиБ.
- skill-creator от Anthropic: создание навыка, проверки с ним и без него, подбор описания.
- Встроенный браузер: вызов через
@Browser, отдельный профиль, ограничения. - Computer Use: установка плагина, вызов
@Computer, особенности macOS и Windows. - Голос в Codex: как работает голосовой агент, цена минуты, общие лимиты.
Собрал бота. А как собрать конвейер?
Один бот закрывает одну задачу. Дальше начинается связка: n8n, Make, агенты в Claude Code и то, что крутится без тебя. Это уже не «ещё один инструмент», а система.
Что за клуб →