01В чём фокус
GPT-6 Astra в Codex хорошо думает и так же хорошо тратит. Лимит подписки заканчивается посреди задачи, и дальше приходится ждать следующего окна или переключаться на модель слабее прямо в середине работы.
Первая реакция обычно такая: поставить модель попроще и смириться с качеством. Это худший вариант, потому что большая часть лимита уходит не на то, что вы видите в ответе, а на то, что происходит вокруг: на уровень усилия выше нужного, на быстрый режим, на картинки, на подключённые серверы и длинные инструкции, которые агент перечитывает в каждой сессии, на поиск файла по всему проекту, когда вы и так знали, где он лежит.
Гайд закрывает одну задачу: растянуть лимит Astra так, чтобы его хватало на неделю работы, и не потерять в качестве там, где оно нужно. Приёмы идут от простого к сложному. Первые включаются за пять минут в настройках, следующие меняют привычки в работе, последние требуют поставить инструменты или завести своих субагентов.
Даже если вы остановитесь на первом блоке, лимит заметно растянется.
02Что нужно до старта
Подписка ChatGPT с доступом к Codex и Codex в любом виде: приложение, командная строка или расширение для редактора. Большинство настроек ниже есть во всех трёх, где они различаются, это сказано.
Команда /status. В командной строке она показывает, сколько лимита осталось. В приложении то же самое лежит в настройках, в разделе Usage. Откройте её до и после, иначе не поймёте, что сработало.
Как устроен лимит. OpenAI описывает два окна одновременно: пятичасовое и недельное. Работать можно, пока остаток есть в обоих. Пятичасовое окно начинается не по часам, а с первого сообщения в Codex после того, как закончилось предыдущее. Эта деталь пригодится в разделе про привычки.
Какие модели под рукой. Astra старшая и самая дорогая. Рядом модели попроще из той же линейки, например Sol и Luna: они дешевле по лимиту и справляются с большей частью рутины. У Luna верхний уровень усилия Max, Ultra для неё нет. Какие модели доступны именно вам, видно в выборе модели в приложении.
Время: полчаса на настройки и привычки, вечер на инструменты и субагентов.
03Ядро
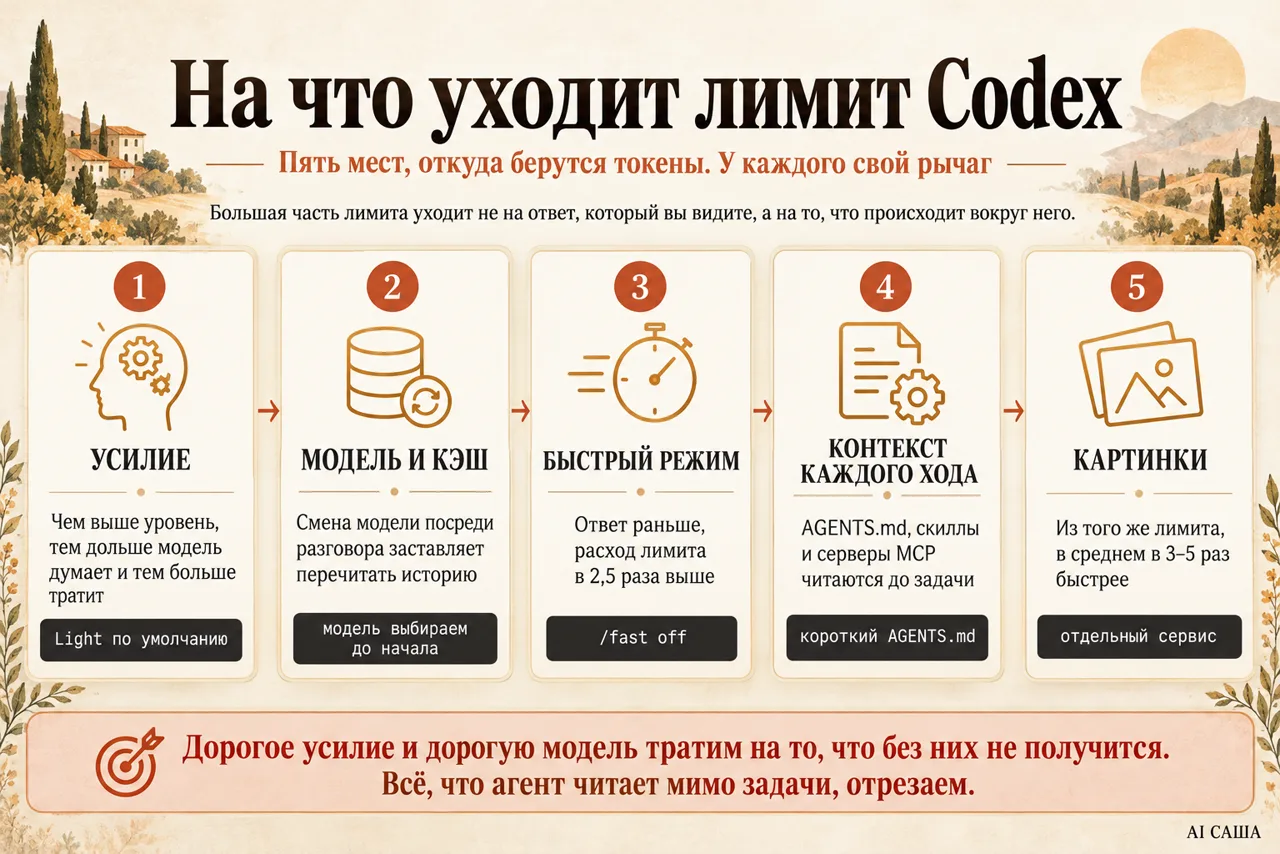
Лимит расходуется в токенах, и токены берутся из пяти мест. Если знать эти пять мест, остальной гайд читается как список рычагов к каждому.
Усилие. Чем выше уровень рассуждения, тем дольше модель думает и тем больше токенов тратит. В приложении уровни называются Light, Medium, High, Extra High, Max и Ultra. Документация OpenAI прямо пишет, что большинству задач не нужны ни Max, ни Ultra.
Модель и кэш. Codex переиспользует уже прочитанное начало переписки, и повторное чтение из кэша стоит в разы дешевле. Смена модели посреди разговора обычно ломает это переиспользование, и историю приходится читать заново по полной цене.
Скорость. Быстрый режим для моделей GPT-6 расходует лимит в 2,5 раза быстрее обычного. Ответ приходит раньше, счёт растёт быстрее.
Контекст каждого хода. Инструкции из AGENTS.md, описания скиллов, каталог подключённых серверов MCP попадают в контекст до вашей задачи. Короткие инструкции почти ничего не стоят, длинные съедают лимит в каждом ходе каждой сессии.
Картинки. Генерация изображений идёт из того же лимита и, по данным OpenAI, расходует его в среднем в три-пять раз быстрее обычного запроса.
Отсюда простое правило: дорогое усилие и дорогую модель тратить только на то, что без них не получится, а всё, что агент читает мимо задачи, отрезать.
04Настройки за пять минут
Начинайте с Light, повышайте по результату. В справке OpenAI есть показательная фраза: Astra на низком усилии может обойти Sol на высоком. Ставьте Light или Medium по умолчанию и поднимайте уровень, только когда ответ не дотягивает. Так вы платите за рассуждения, которые нужны, а не на всякий случай.
Потолок Extra High, а не Max. Независимый замер Artificial Analysis по Astra показывает, как быстро падает отдача. Переход с High на Extra High стоит на 30 процентов дороже и даёт полтора пункта их индекса интеллекта. Переход с Extra High на Max стоит ещё на 40 процентов дороже и даёт меньше трети пункта. Если бюджет не бесконечный, Max ставить незачем.
Ultra устроен иначе, чем остальные уровни. Он стоит на том же ползунке, но работает по-другому: задача делится на части, и каждую параллельно делает отдельный субагент. По документации такая работа съедает заметно больше токенов, чем один агент. Для обычной задачи, где нужно подумать глубже, хватает Extra High. Ultra оставьте для больших задач, где правда нужна команда. Если Max или Ultra нет на ползунке, их включают в настройках приложения: для Ultra это пункт Ultra in model picker slider в разделе Configuration. Раз они по умолчанию спрятаны, случайно вы их не включите, а включив, помните, что каждый такой прогон заметно дороже.
Модель выбирается до первого сообщения. Решите заранее, нужна ли тут Astra или хватит модели попроще. Смена модели в середине разговора обычно заставляет перечитать всю историю по полной цене. В справке OpenAI этот совет стоит отдельным пунктом: модель и уровень выбирать до начала.
Быстрый режим выключен по умолчанию. Включайте его командой /fast on только тогда, когда правда горит, и выключайте /fast off. Лёгкие уровни усилия и так отвечают быстро.
Поправки в процессе, а не после. Когда агент пошёл не туда, многие ждут, пока он закончит, и потом поправляют. Все эти минуты вы платите за работу, которую выбросите. В приложении в настройках есть пункт Follow-up behavior: переключите его на режим steer, и сообщение, отправленное во время работы, сразу поправит текущий ход. В расширении для редактора это настройка chatgpt.followUpQueueMode со значением steer, в командной строке Enter вмешивается в текущий ход, а Tab ставит сообщение в очередь.
Картинки через отдельный сервис. Если Codex рисует вам обложки и иллюстрации, этим он тратит лимит в разы быстрее. Подключите сторонний сервис с API картинок, и лимит Codex на них тратиться не будет. Мы пользуемся kie.ai: там GPT Image в разрешении 1K стоит около трёх центов за картинку.
05Пусть агент меньше читает
Заметная часть лимита уходит на то, что агент ищет и читает. Каждый лишний открытый файл это токены, которые не приблизили задачу к финишу.
Дайте путь к файлу сами. Если вы знаете, в каком файле правка, скопируйте путь и вставьте в сообщение. В проводнике Windows путь копируется сочетанием Ctrl+Shift+C. Это быстрее и дешевле, чем отпустить агента искать самому по всему проекту.
Заведите карту проекта. Короткие markdown-файлы, которые говорят, где что лежит: один про контент, один про продукт, один про автоматизации. Агент сначала читает карту и открывает только нужный файл, вместо того чтобы перебирать папки подряд.
Сделайте AGENTS.md оглавлением. Codex читает AGENTS.md перед любой работой, и всё, что в нём лежит, сидит в контексте каждого хода. Если файл разросся, вынесите разделы в отдельные файлы, а в AGENTS.md оставьте по строке со ссылкой. Документация OpenAI советует ровно это: держать главный файл коротким и ссылаться на файлы под задачи. Агент откроет их, когда понадобится.
Промпт, который делает обе вещи сразу:
Посмотри на мой проект и на AGENTS.md. Сделай две вещи.
1. Заведи по одному короткому файлу-карте на каждую крупную область работы
   (контент, продукт, автоматизации или что у меня есть на самом деле):
   что где лежит, одна строка на папку или ключевой файл.
2. Если AGENTS.md длиннее пары экранов, вынеси разделы в отдельные файлы,
   а в AGENTS.md оставь короткое оглавление: одна строка на раздел со
   ссылкой на файл и на карты из первого пункта.
Ничего не удаляй без моего подтверждения. В конце покажи, сколько строк
было в AGENTS.md и сколько стало.
Выключите то, чем не пользуетесь. Каждый подключённый сервер MCP добавляет свои инструменты в каталог, который агент видит с первого хода. Сервер выключается строкой enabled = false в его разделе конфигурации, плагин кнопкой Uninstall или отключением в настройках. Скиллы дешевле: в контекст идут только их названия и описания, а полный текст загружается, когда скилл нужен.
Раз в месяц уборка. Инструкции, скиллы, плагины и серверы копятся незаметно. Попросите Codex завести ежемесячную запланированную задачу (в Codex это называется Scheduled tasks): пройтись по AGENTS.md, скиллам и подключениям и отметить дубли, устаревшее и слишком длинное. Решение, что удалить, остаётся за вами. Ставьте её на последний день недельного окна, чтобы тратить лимит, который всё равно сгорит.
Сжимайте переписку, когда она разрослась. Команда /compact сжимает длинный разговор в короткую выжимку, а при приближении к пределу Codex делает это сам. Выжимка теряет детали, которые важны именно вам. Перед сжатием полезно попросить агента перечислить, что он сохранит, и поправить список. Если вы хотите, чтобы сжатие всегда учитывало ваши правила, в конфигурации есть параметр compact_prompt со своей инструкцией для выжимки.
Спросите агента, что ест лимит. Самый дешёвый приём из всех: агент сам знает свою конфигурацию лучше, чем вы помните её. Попросите его пройтись по настройкам и назвать главных пожирателей. Обычно находятся три вещи: плагины и серверы, которыми вы не пользуетесь, уровень усилия по умолчанию выше, чем нужно задачам, и субагенты, которые при каждом запуске получают всю историю разговора целиком.
Проверь мою конфигурацию Codex и скажи, что сильнее всего расходует лимит.
Посмотри: уровень усилия и модель по умолчанию, включён ли быстрый режим,
какие серверы MCP, плагины и скиллы подключены и какими я пользовался
в последних разговорах, насколько длинные AGENTS.md и файлы, на которые
он ссылается, какие субагенты у меня заведены и что они получают при
запуске. Дай список от самого дорогого к самому дешёвому, с одной строкой
«что сделать» у каждого пункта. Ничего не меняй, пока я не выберу.
Эту проверку полезно повторять раз в месяц вместе с уборкой: конфигурация обрастает так же незаметно, как рабочий стол.
06Пусть агент короче отвечает и меньше пишет
Следующий слой это не то, что агент читает, а то, что он пишет. Длинные ответы и лишний код тоже идут из лимита. Здесь помогают открытые скиллы и плагины, которые ставятся одной ссылкой: вставьте ссылку на репозиторий в Codex и попросите установить. Чтобы понять, помог ли инструмент, ставьте их по одному и сравнивайте расход на похожих задачах.
Установи скилл по ссылке [ссылка на репозиторий] так, как написано в его
README для Codex. Перед установкой коротко перескажи, что он делает и
какие файлы добавит. После установки скажи, как его выключить, если он
мне не подойдёт. Запомни остаток лимита по /status сейчас, через неделю
я попрошу сравнить.
Caveman (github.com/JuliusBrussee/caveman) заставляет агента отвечать короткими прямыми фразами без воды. По собственной проверке авторов, медианный ответ становится вдвое короче по выходным токенам. В независимом тесте на 86 задачах, который приводят сами авторы, экономия скромнее, около 8,5 процента. Ставить стоит, но чудес ждать не нужно.
I have ADHD (github.com/ayghri/i-have-adhd) делает похожую вещь с другой стороны: не даёт агенту прятать главный ответ в середине стены текста. Про экономию токенов авторы ничего не обещают, зато ответы читаются быстрее, и вы меньше листаете.
Ponytail (github.com/DietrichGebert/ponytail) создан для кода: агент пишет минимум, как самый ленивый старший разработчик в команде. Авторы намерили около половины кода и на пятую часть меньше токенов, но на модели Claude Haiku 4.5, и честно предупреждают, что на моделях GPT цена может сдвинуться в другую сторону. Проверьте на своих задачах.
Для тех, кто работает в терминале много. Следующие три инструмента сложнее, но экономят там, где скиллы бессильны.
- RTK (github.com/rtk-ai/rtk) обрезает вывод команд терминала до того, как его прочитает агент. Авторы пишут про экономию от 60 до 90 процентов токенов на типовых командах разработки и сами оговаривают, что это не то же самое, что счёт в 10 раз меньше: вывод команд лишь часть расхода. Подключается к Codex командой
rtk init -g --codex. - Headroom (github.com/headroomlabs-ai/headroom) сжимает всё, что агент читает: логи, файлы, результаты инструментов. RTK трогает только вывод терминала, Headroom шире. Авторы называют около 20 процентов экономии для агентов в программировании.
- QMD (github.com/tobi/qmd) ищет по смыслу, а не по точному совпадению слов. Полезен, когда в проекте тысячи заметок и файл назван не так, как вы его ищете: агент находит нужное сразу, а не открывает файлы по одному. Работает локально и умеет подключаться как сервер MCP.
07Дорогая модель думает, дешёвые делают
Последний блок самый выгодный на больших задачах. Astra нужна там, где надо думать: спланировать, разложить, проверить. Выполнять подзадачи могут модели проще.
Свои субагенты на своей модели. В Codex субагент это файл в формате TOML в папке ~/.codex/agents/ (такой агент доступен во всех проектах) или .codex/agents/ (только в этом проекте). Обязательные поля: name, description и developer_instructions, а в поле model задаётся модель. Заведите, например, агента для выжимки длинных документов на модели попроще, и рутинная работа перестанет тратить лимит Astra.
Заведи мне субагента для рутинных задач. Файл в ~/.codex/agents/,
имя summarizer, описание: выжимки длинных документов, переписок и
логов. Модель выбери самую дешёвую из тех, что мне доступны, уровень
усилия Low. Инструкция: выжимка по пунктам, без вступлений, факты не
додумывать. Покажи файл и объясни, как вызвать агента из любого чата.
Мозг и руки. На большой задаче попросите Astra только спланировать: разложить работу на подзадачи, раздать их субагентам на дешёвых моделях и проверить результат. Думает дорогая модель, руками работают дешёвые.
Эту задачу делаем по схеме «мозг и руки». Ты только планируешь и
проверяешь: разложи работу на подзадачи, каждую отдай субагенту на самой
дешёвой модели, которой она по силам (для рутины используй summarizer
и других моих агентов из ~/.codex/agents/). Сам код и тексты не пиши,
пока субагент не вернул результат. Проверь каждый результат, верни на
доработку то, что не годится, и в конце дай мне короткий отчёт: какие
подзадачи были, кто их делал и что пришлось переделать.
Ultra делает похожее сам, но, по документации, такие прогоны тратят заметно больше токенов, чем один агент, а в своей схеме вы сами решаете, какой модели что отдать.
Регулярное оптимизируйте один раз. Если какая-то работа повторяется каждую неделю (отчёт, выгрузка, разбор заявок) и заметно ест лимит, попросите Astra разобрать этот процесс и переделать его экономнее: вынести рутину субагенту, отрезать лишнее чтение, сохранить шаги в скилл. Это занимает один вечер, а окупается каждую неделю.
Окно открывайте заранее. Пятичасовое окно начинается с первого сообщения. Если вы садитесь за работу в девять и к одиннадцати упираетесь в лимит, окно обновится только в два. Запланированная задача, которая в шесть утра отправит агенту короткое «привет», откроет окно раньше, и новое начнётся в одиннадцать. Учтите, что для локальных проектов компьютер должен быть включён, а приложение запущено.
Про бюджет в промпте. Можно встретить совет писать агенту «уложись в 3 процента недельного лимита». В документации OpenAI не сказано, что модель видит остаток вашего лимита, поэтому на такую фразу полагаться нельзя. Работает другое: задать границы, которые агент может проверить сам (не больше стольких-то файлов, не больше стольких-то шагов, остановись и спроси перед большой переделкой), и смотреть /status до и после.
08Свой результат за вечер
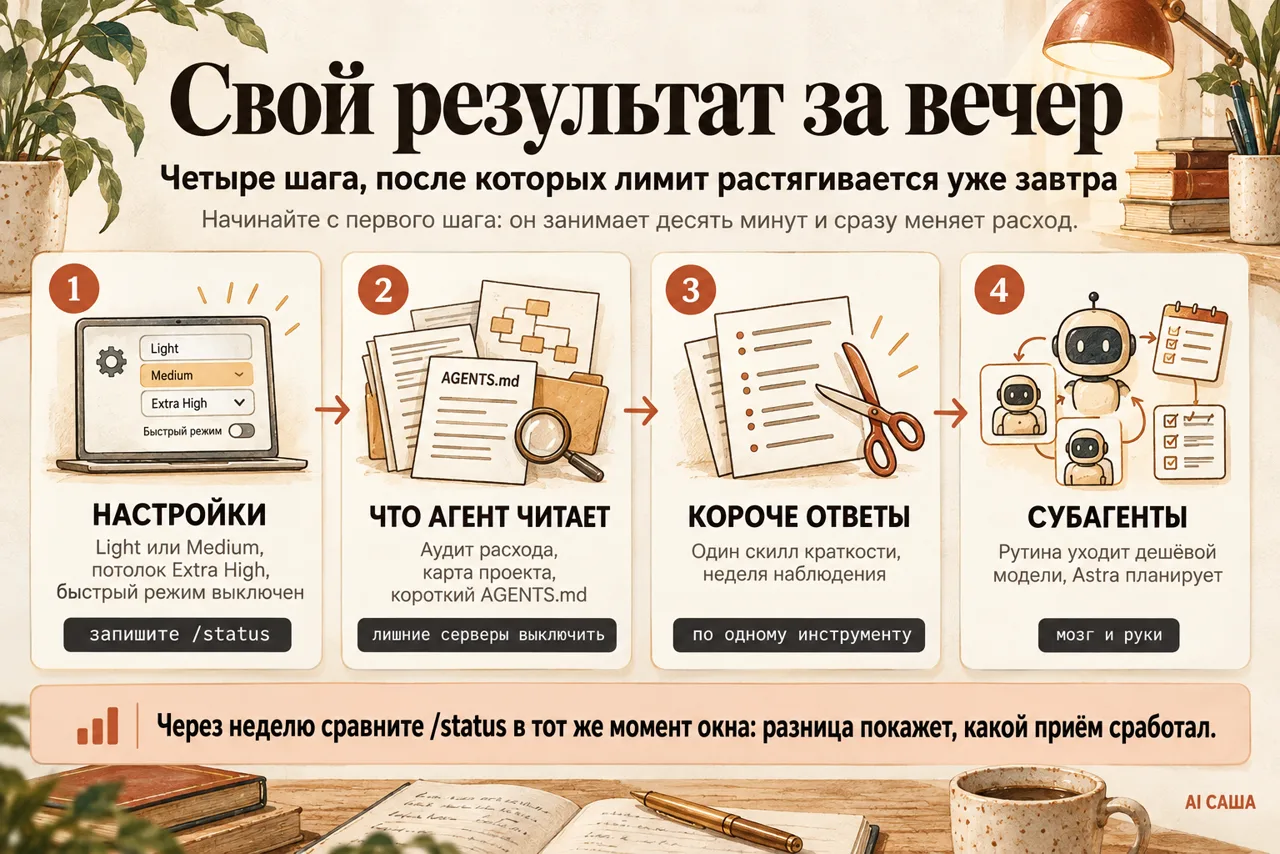
Четыре шага, после которых лимит заметно растягивается уже завтра.
Шаг 1. Настройки
Уровень по умолчанию Light или Medium, потолок Extra High, быстрый режим выключен, Follow-up behavior в режиме steer. Если Ultra стоит у вас на ползунке по умолчанию, переставьте ползунок ниже и возвращайтесь к Ultra сознательно, на большие задачи. Проверьте /status и запишите остаток, чтобы было с чем сравнить. На всё уходит минут десять.
Шаг 2. Что агент читает каждый ход
Сначала промпт-аудит из раздела 5: пусть агент назовёт, что у вас ест лимит. Потом промпт на карты проекта и короткий AGENTS.md. Выключите серверы MCP и плагины, которыми не пользовались последний месяц, и переведите картинки на отдельный сервис. Здесь уходит больше всего времени, зато этот шаг обычно даёт самую заметную разницу.
Шаг 3. Короче ответы
Поставьте один скилл краткости, Caveman или I have ADHD, и неделю посмотрите, как меняются ответы. Если пишете код, попробуйте Ponytail на паре задач и сравните расход.
Шаг 4. Субагенты
Заведите одного субагента на дешёвой модели под свою самую частую рутину: выжимки, переименования, разбор логов. На следующей большой задаче запустите промпт «мозг и руки» из раздела 7 и посмотрите, какую часть работы Astra отдала и как часто пришлось переделывать. Если субагент на дешёвой модели часто ошибается, поднимите ему уровень усилия, а не модель.
Через неделю снова откройте /status в тот же момент окна и сравните.
09Что ты увидишь
До настройки Astra стоит на Max или Ultra на любой задаче, быстрый режим включён, AGENTS.md на несколько экранов, подключены все серверы, которые когда-то пробовали. Агент ищет файлы сам, отвечает стеной текста, картинки рисует тут же. Лимит заканчивается к середине дня, и остаток недели проходит в ожидании окна.
После настройки по умолчанию стоит лёгкий уровень, высокий только там, где ответ не дотянул. Агент открывает карту и сразу нужный файл, отвечает коротко, рутину отдаёт субагенту на дешёвой модели, картинки уходят в сторонний сервис. Astra тратит лимит на планирование и сложные места, и того же лимита хватает на заметно больше работы.
Сравнивайте честно. Расход сильно зависит от задач: неделя правок в маленьком проекте и неделя большой переделки дадут разные цифры при любых настройках. Смотрите /status в одинаковый момент окна и на похожей работе, а лучше повторите одну и ту же типовую задачу до и после настройки. Тогда видно, какой приём дал разницу, а какой просто совпал с лёгкой неделей.
10Чтобы не споткнуться
Сменить модель посреди длинного разговора. Кажется, что это экономия: перешли на модель проще и доделали. На деле новая модель заново читает всю историю по полной цене, без кэша. Если задача меняется, лучше открыть новый разговор с короткой выжимкой.
Поставить все инструменты экономии разом. Caveman, Ponytail, RTK и Headroom по отдельности каждый что-то дают, но если включить их в один день и лимит вырастет или упадёт, вы не поймёте, что сработало. Ставьте по одному и сравнивайте /status через одинаковое время.
Считать Ultra просто самым умным режимом. Ultra раскладывает задачу на параллельных субагентов, и каждый из них тратит лимит. На маленькой задаче это переплата в разы без выигрыша в качестве.
11А если…
…лимит всё равно кончается? Посмотрите, что именно его ест. Попросите Codex разобрать вашу конфигурацию: какие плагины и серверы подключены, какой уровень усилия стоит по умолчанию, какие субагенты копируют весь разговор при каждом запуске. Обычно находится одна-две вещи, которые съедают больше остального.
…Light отвечает хуже, чем я привык? Так и должно быть на части задач. Смысл не в том, чтобы всё делать на Light, а в том, чтобы начинать с него и поднимать уровень, когда видно, что не хватило. Большинство правок, переименований и коротких ответов на Light проходят без потерь.
…инструменты сжатия не испортят ответы? Могут, поэтому их ставят по одному. RTK режет вывод команд, и если агенту нужна была именно обрезанная строка лога, он её не увидит. Если после установки агент начал ошибаться на задачах, где раньше справлялся, выключите последний инструмент и проверьте снова.
…где смотреть, сколько осталось? В командной строке командой /status, в приложении в настройках, в разделе Usage. Смотрите на оба окна: пятичасовое может быть почти полным, а недельное уже на исходе, и наоборот.
…это работает в Claude Code? Большая часть приёмов общая: карта проекта, короткий файл инструкций, выключенные серверы, субагенты на дешёвых моделях, скиллы краткости. Названия настроек и файлов другие, а логика та же.
12Зачем на самом деле
Лимит это не только про деньги. Это про то, сколько работы вы успеваете сделать с агентом, пока не встали. Когда лимит кончается к обеду, вы начинаете экономить на задачах: откладываете сложное, не проверяете, делаете руками то, что агент сделал бы лучше.
Когда дорогая модель тратится на мысли, а рутина уходит дешёвым, лимит перестаёт быть потолком. Навык, который здесь качается, шире Codex: видеть, какая работа требует лучшей модели, а какая нет, и строить работу так, чтобы сильная модель не тратила себя на поиск файлов и длинные ответы.
Этот навык переживёт любую модель. Через полгода появятся новые версии, изменятся названия уровней и цены, лимиты станут другими. Привычка давать агенту карту вместо поиска, держать инструкции короткими, отдавать рутину дешёвым исполнителям и включать дорогое только по делу останется рабочей при любых настройках.
13А дальше
Claude тратит лучшую модель на мелочи про ту же идею с другой стороны: быстрая модель принимает решения за доли секунды и почти даром, а большая пишет только то, что нужно написать. Там же собран маршрутизатор, который сам отдаёт мелкие задачи младшей модели.
Один Клод не справляется. Собери рой про субагентов: как их заводить, что они видят и почему стартуют с чистой головы. Приём «мозг и руки» из этого гайда стоит именно на них.
14Источники
Управление лимитом с GPT-6 Astra: https://help.openai.com/en/articles/20001516-managing-usage-with-gpt-6-astra-in-work-and-codex Пятичасовое и недельное окна, выбор модели и уровня до начала работы.
Модели и уровни усилия в Codex: https://learn.chatgpt.com/docs/models Уровни от Light до Ultra, что делает Ultra и как включить его на ползунке.
Цены и лимиты Codex: https://learn.chatgpt.com/docs/pricing Недельные лимиты, команда /status, расход лимита на картинки.
Быстрый режим: https://learn.chatgpt.com/docs/agent-configuration/speed Расход в 2,5 раза выше обычного и команды /fast.
AGENTS.md: https://learn.chatgpt.com/docs/agent-configuration/agents-md Когда Codex читает инструкции, вложенные файлы и предел размера.
Субагенты: https://learn.chatgpt.com/docs/agent-configuration/subagents Файлы агентов, поля name, description, developer_instructions, model.
Запланированные задачи: https://learn.chatgpt.com/docs/automations Задачи по расписанию, в том числе ежемесячные.
Замеры Artificial Analysis по GPT-6 Astra: https://artificialanalysis.ai/models/gpt-6-astra Индекс интеллекта и стоимость прогона на разных уровнях усилия.
Собрал бота. А как собрать конвейер?
Один бот закрывает одну задачу. Дальше начинается связка: n8n, Make, агенты в Claude Code и то, что крутится без тебя. Это уже не «ещё один инструмент», а система.
Что за клуб →